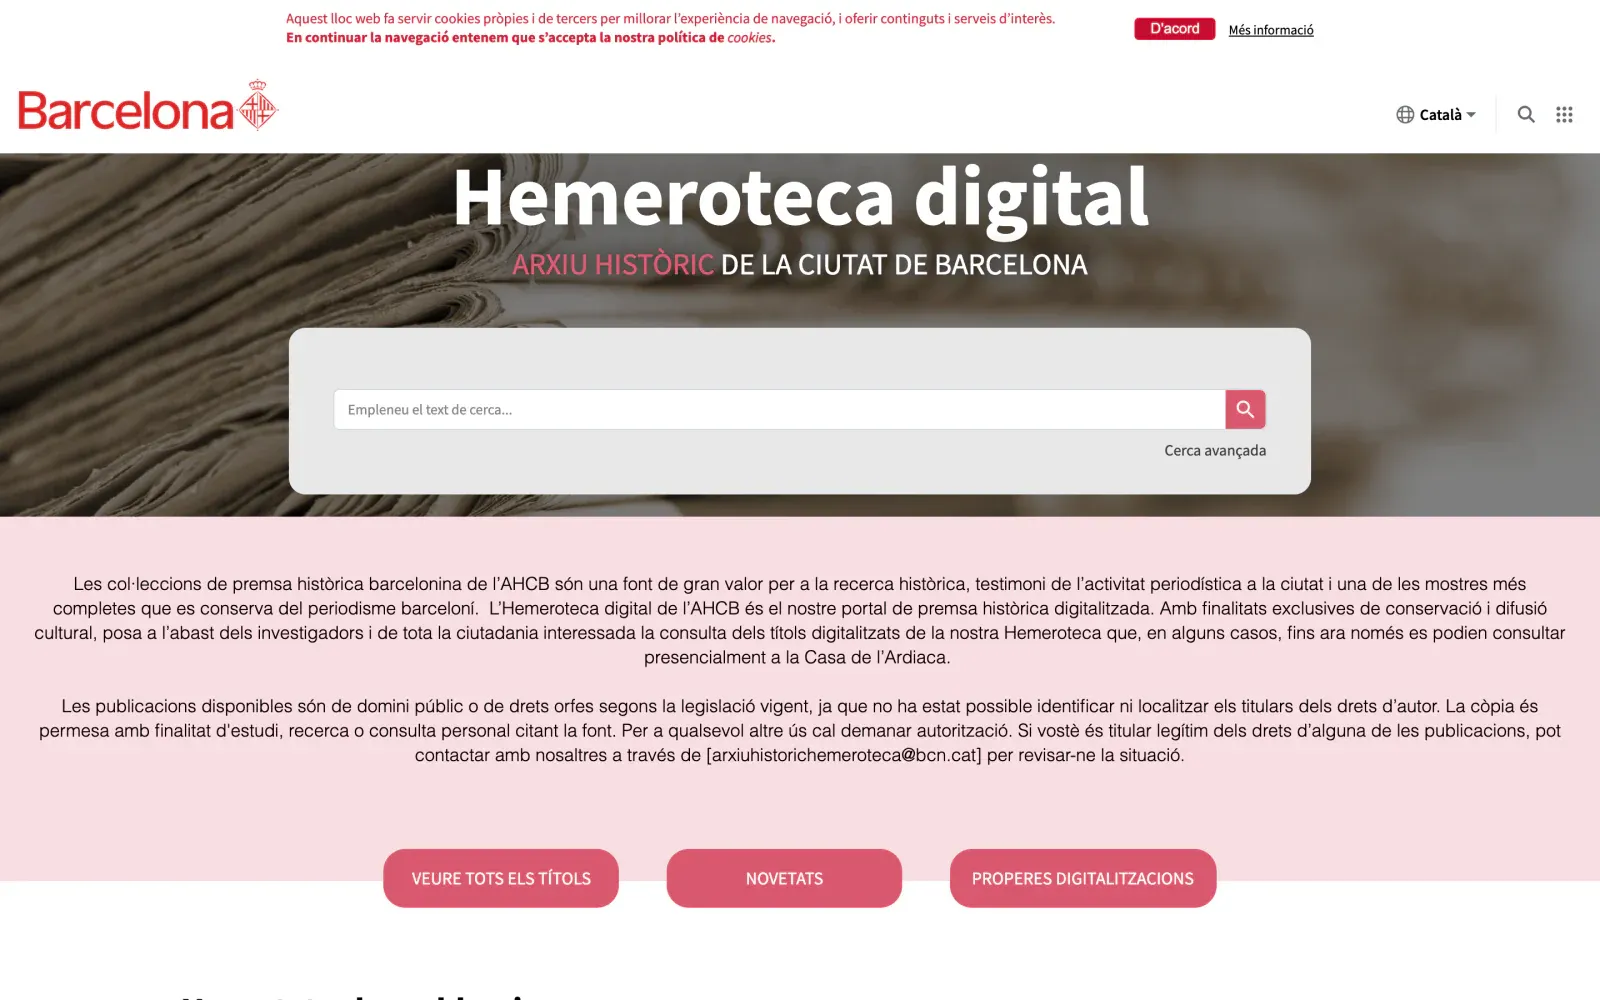
Hemeroteca Digital
Arxiu històric de la ciutat de Barcelona
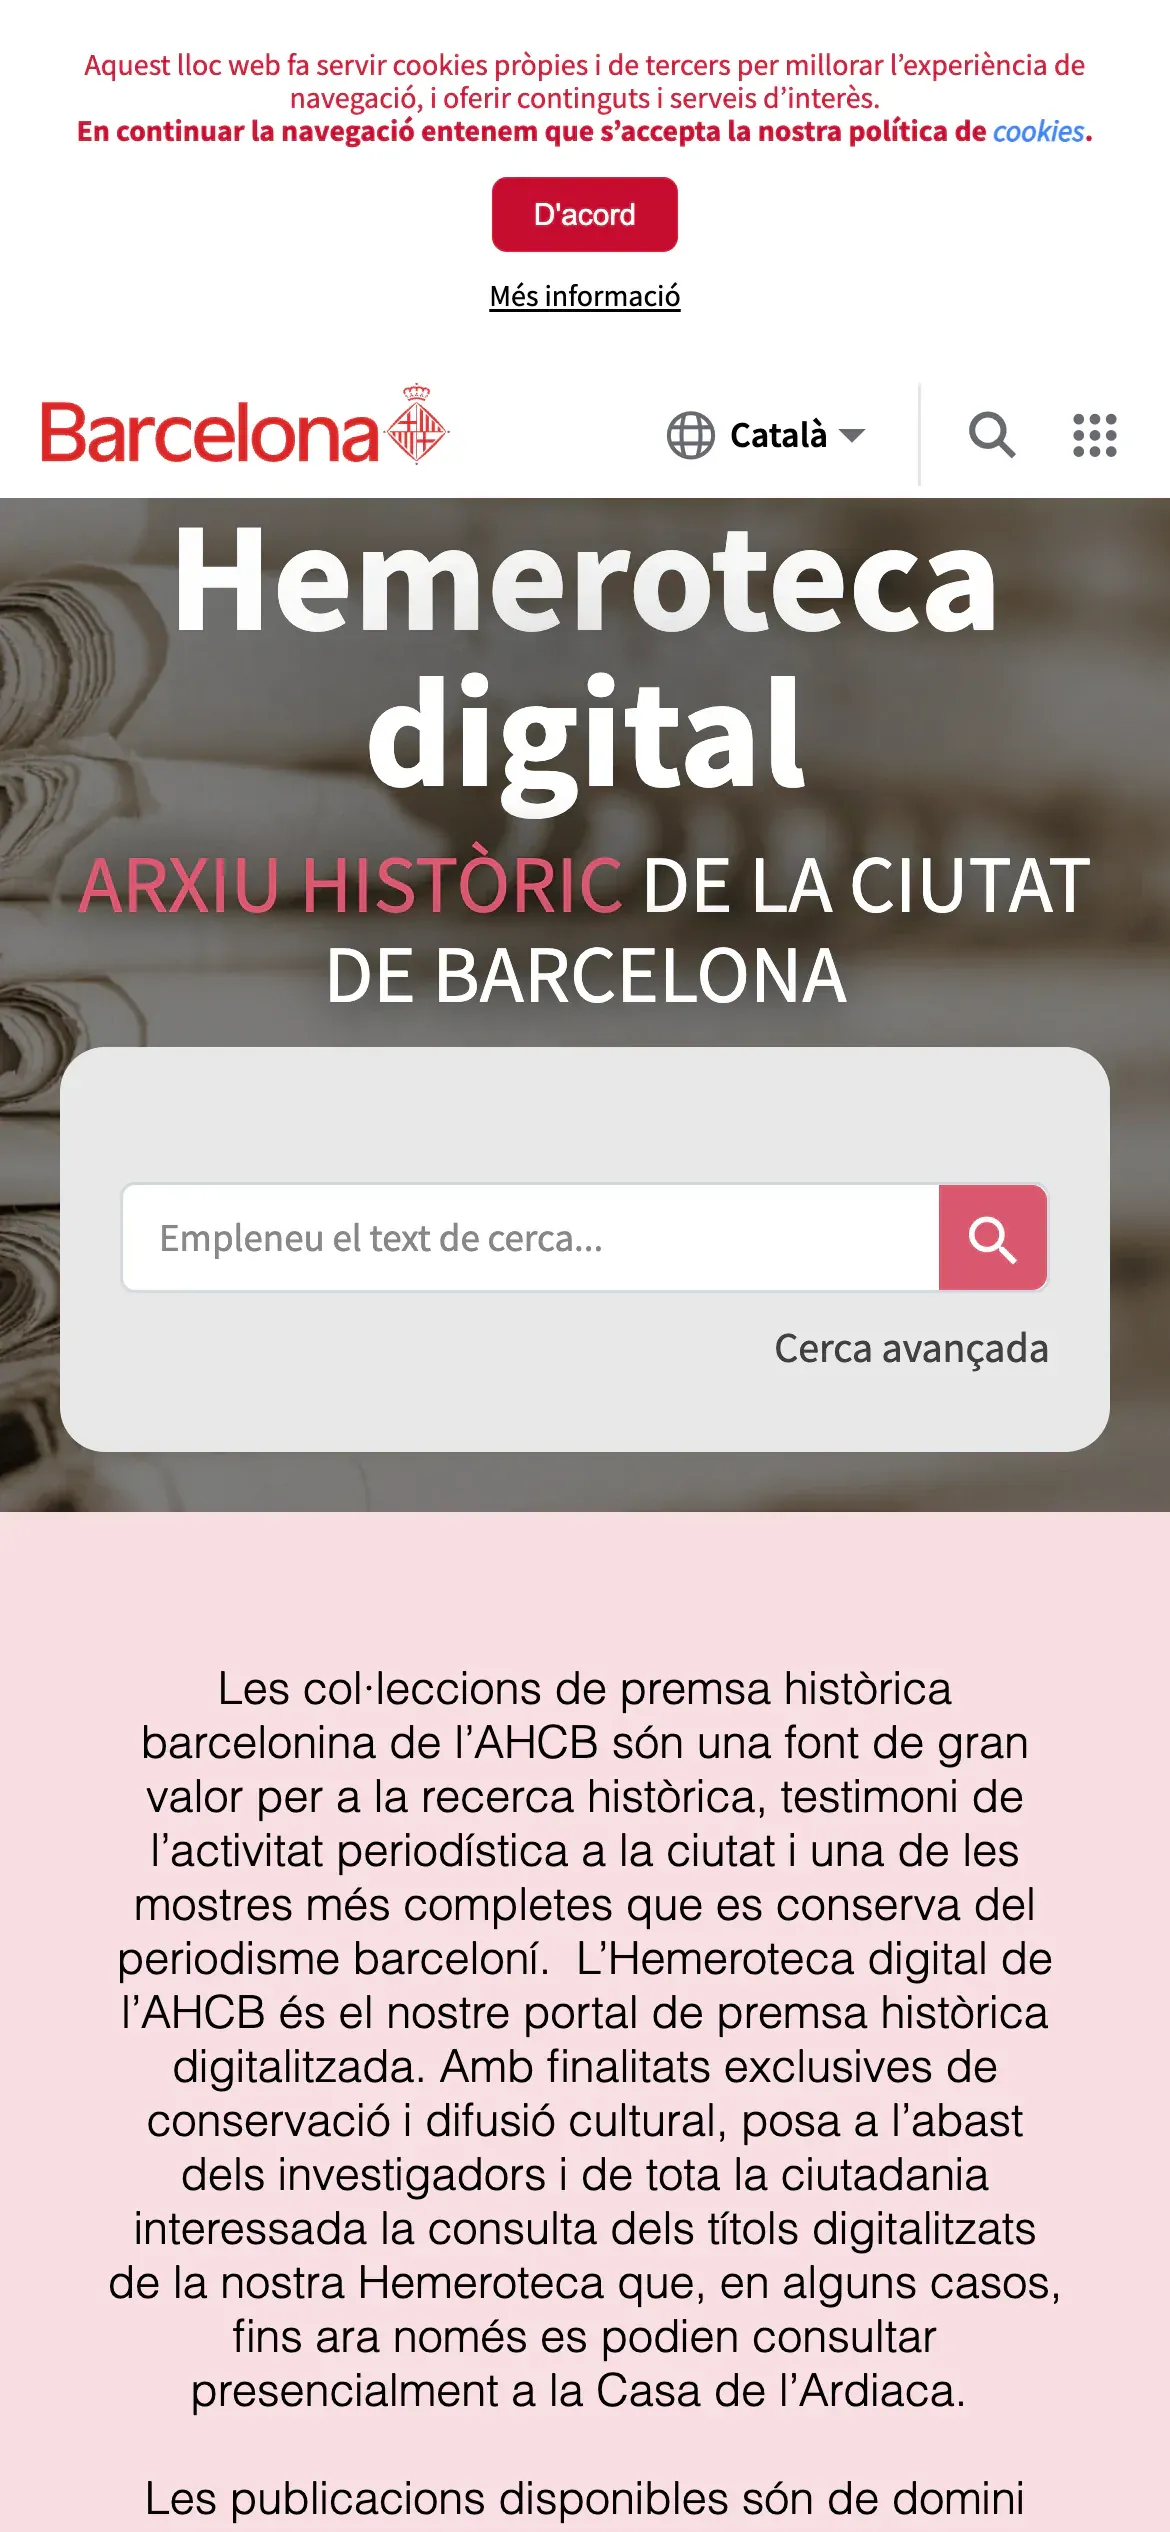
Herramienta que permite acceder a los documentos digitalizados por el Archivo Histórico de la ciudad de Barcelona. Permite buscar mediante palabras clave, año de publicación, autor, etc. Desarrollo full-stack, diseño y arquitectura de la plataforma.
- Cliente
- Arxiu històric de la ciutat de Barcelona
- Sector
- Cultura y patrimonio
- Año
- 2019–2023
- Duración
- 4 años y medio
El reto
El Archivo Histórico de la Ciudad de Barcelona conserva uno de los fondos de prensa más importantes de Cataluña: más de dos siglos de diarios y revistas digitalizados, del Diario de Barcelona (1792) a las revistas de la Guerra Civil y la prensa clandestina del exilio.
Todo ese fondo existía como miles de imágenes digitalizadas, pero sin ninguna herramienta pública para consultarlo. Hacía falta una plataforma capaz de indexar cientos de miles de páginas y hacerlas buscables para investigadores y ciudadanía — con grafías que van del siglo XVII al XX.
La solución
Diseñamos y desarrollamos la plataforma completa: arquitectura, diseño, front end y back end, con Laravel y Vue.
El corazón es un buscador construido sobre Elasticsearch, y la elección no fue casual: una base de datos convencional no está hecha para buscar dentro de cientos de miles de páginas de texto extraído por OCR — las consultas serían lentas y sin noción de relevancia. Elasticsearch indexa cada palabra por adelantado, responde en milisegundos y ordena los resultados por lo que realmente encaja, por grande que sea el fondo, sin hacer más pesado el resto de la plataforma.
Sobre este motor configuramos un análisis a medida del fondo: búsqueda insensible a acentos y mayúsculas — imprescindible con grafías catalanas y castellanas que van del siglo XVII al XX — y filtros combinables por colección, título, autor, fecha e idioma, que el propio índice calcula en cada búsqueda.
La plataforma se conecta con la API del Institut de Cultura de Barcelona. El equipo del archivo lanza la sincronización desde el backoffice: parcial, solo con los documentos nuevos o modificados desde la última, o completa. El servidor la procesa en segundo plano por lotes, con seguimiento del progreso y la posibilidad de volver a procesar los documentos que han fallado. Incorporar documentos nuevos no requiere cargarlos a mano.
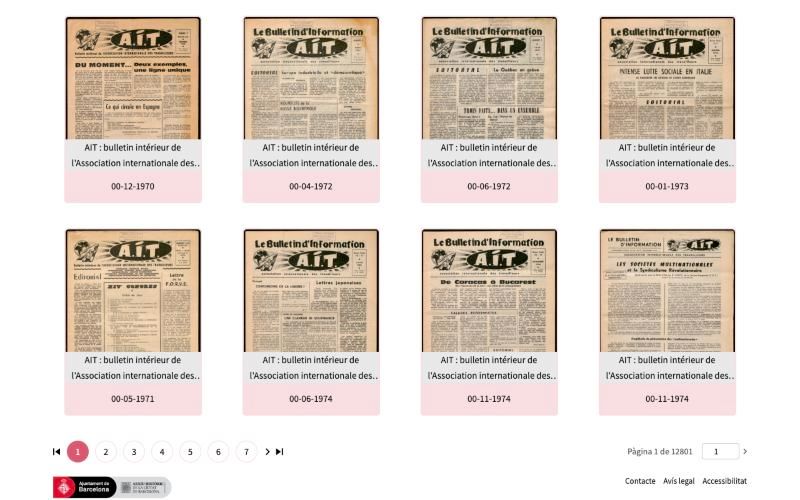
El resultado son dos webs en una — Hemeroteca y Biblioteca — con visor de documentos, consulta de PDF, web multilingüe y un backoffice para que el equipo del archivo gestione colecciones y títulos.
Resultados
- +3.300
- Títulos de publicaciones consultables
- 2 siglos
- De prensa digitalizada (1792–1994)
- +1.100
- Títulos de prensa clandestina y del exilio
- 4,5 años
- De evolución continua (2019–2023)